A persona sintética serve a uma decisão e precisa provar até onde vale
Este guia ensina o método do Kit 1 para qualquer estudo de persona: você traz as suas entrevistas, diz que decisão está em jogo, e o kit transforma esse material numa persona que cita a fonte de cada fala, é medida contra o próprio corpus e depois contra uma pessoa que ela nunca viu. No fim sai um relatório que diz para que a persona serve e para que não serve.
As decisões que o kit ajuda a tomar
Uma persona feita de entrevistas não mede mercado. Ela ajuda nas decisões que vêm antes do campo humano, quando ainda dá para mudar o instrumento:
Quais perguntas entram no campo
Aquecer e testar o roteiro de entrevista ou o questionário antes de gastar o campo, que muitas vezes só roda uma vez.
Com que palavras perguntar
Explorar como o público fala do assunto, para escrever perguntas e estímulos na língua dele, e não na do relatório.
O que testar primeiro
Levantar e ordenar hipóteses por segmento, com a trilha de evidência de cada uma, para o campo confirmar ou derrubar.
O kit recusa, por construção, as decisões que pedem número: estimar preço, intenção de compra, nota ou proporção de gente. Para essas, o caminho é o campo humano ou o kit quantitativo com base humana.
O que você leva no fim
- Uma persona principal do segmento que você escolheu, e uma persona por cluster de perfil, cada uma com atributos presos a trechos do corpus.
- Três rodadas de entrevista com a persona, um painel de calibração contra o corpus e uma validação contra uma entrevista que ficou de fora.
- Um relatório de auditoria com a faixa de uso de cada aplicação e um parágrafo de disclosure pronto para o relatório ao cliente.
- O relatório de calibração e validação em HTML e PDF, com três gráficos, e o documento Personas do estudo em PDF, Word e TXT.
- Um chat local em que você conversa com as personas, com o id do trecho, a marca [INFERÊNCIA] e o lastro em cada resposta.
Todas as informações do seu estudo, os dados, a curadoria, as saídas e o estado do projeto, ficam dentro de projetos/, numa subpasta com o nome do seu estudo: projetos/NOME_DO_ESTUDO/. Um estudo por pasta. O diretor e os scripts sempre recebem --projeto projetos/NOME_DO_ESTUDO. A seção A pasta do seu estudo mostra a árvore completa.
O kit já vem com um projeto de treino em projetos/nuvem_casa/. É um caso fictício: uma marca de pastilha concentrada que vira limpador multiuso, com doze entrevistas (E01 a E12) em quatro faixas etárias e três conceitos de comunicação. A decisão escrita no escopo é "quais hipóteses sobre o público de 60 anos ou mais entram no roteiro do campo humano único, e com que vocabulário". A persona principal junta E10, E11 e E12. Ao longo do guia, cada passo mostra primeiro o que você faz no seu estudo e depois, nestas caixas, como ficou no exercício, com os números da execução de referência de 19/10/2026.
O método abre o corpus em clusters, fecha um laço de calibração e guarda a validação num cofre
Este é o desenho do método inteiro, na ordem em que o diretor conduz. Cada caixa é clicável.Clique num nó, use as setas do teclado ou aperte Percorrer o fluxo.
- entrada
- processo
- saída
- portão do diretor
- cofre, abre uma vez
- laço de ajuste
- separada no início
O painel mostra o que entra, o que o agente faz, o que sai e o comando de cada passo.
Uma frase na conversa basta para o diretor criar a pasta e conduzir o briefing
Simulação do primeiro encontro com o diretor, baseada no diálogo de teste do kit. A árvore de pastas, ao lado ou logo abaixo no celular, nasce como o script cria de verdade.Aperte Iniciar e responda clicando nos botões.
começar um projeto novo de [tema do estudo, por exemplo café da manhã de aposentados]A conversa aparece aqui.
- projetos/
- nuvem_casa/ exemplo do kit
O método prende cada fala a um trecho real e mede a persona contra gente que ela nunca viu
Antes do passo a passo, a lógica. Cada etapa existe para fechar uma porta por onde a persona inventa, e cada escolha técnica foi feita para que você consiga conferir o resultado à mão.
O problema de pesquisa que o método resolve
Pedir a um modelo de linguagem que "responda como uma mulher de 65 anos" produz texto fluente e plausível. O problema é que ninguém consegue dizer de onde veio cada afirmação. O modelo completa com o que é estatisticamente comum na internet, e o resultado tende ao estereótipo do grupo. A literatura mede isso: respostas sintéticas variam menos do que as humanas, e o modelo tende a achatar e a retratar mal grupos de identidade.
Ao mesmo tempo, quem pesquisa tem um problema real: o campo humano é caro, às vezes roda uma vez só, e um roteiro mal escrito desperdiça a única chance. O método do kit usa o modelo para o que ele faz bem, organizar e conversar a partir de material humano, e cerca o que ele faz mal, inventar e generalizar.
Bisbee e colegas (2024) compararam respostas sintéticas com um survey eleitoral de referência e acharam desvios padrão muito menores no sintético, o que atrapalha qualquer inferência feita a partir dele. Wang, Morgenstern e Dickerson (2024) testaram quatro modelos com 3.200 participantes de 16 identidades e mostraram que o modelo tende a retratar mal e a achatar grupos. Por isso o kit mede achatamento e fala de categoria, e não só "se a resposta soa bem".
Fontes: Bisbee et al., Political Analysis, 2024; Wang, Morgenstern e Dickerson, arXiv 2402.01908.
A lógica do método, em sete movimentos
| Movimento | O que acontece | Que porta fecha | Etapa |
|---|---|---|---|
| 1. Pergunta e decisão escritas | Você fixa a pergunta, a decisão, o público, a frase de recusa e as lacunas | A persona que responde a tudo e não pode ser cobrada | 1 |
| 2. Corpus real curado | Entrevistas humanas, com permissão, sem dado pessoal, cada parágrafo com id | A persona feita de senso comum, sem gente por trás | 2 |
| 3. Análise e clusters | Leitura do corpus inteiro, tensões, lacunas, jeito de falar, grupos de perfil | Construir antes de ler, e perder a divergência dentro do público | 3 |
| 4. Índice e busca com citação | O corpus vira trechos com id e vetores, e a busca devolve o trecho com a citação | Afirmação sem fonte conferível | 4 |
| 5. Persona em camadas, uma por cluster | Atributos com id, tom de voz tirado do corpus, recusa e expansão controlada no system prompt | Persona inventada com nome, biografia e simpatia | 5 |
| 6. Execução e calibração contra o corpus | Três rodadas em conversas novas, medidas de lastro, consistência, recusa, estereótipo | Uma resposta boa por acaso, uma persona que muda de história | 6 e 7 |
| 7. Validação e decisão | Uma entrevista que ninguém usou é aberta uma vez e comparada, e cada uso ganha uma faixa | Persona ajustada para passar no teste, e uso além do que ela sustenta | 8 e 9 |
Há uma separação que atravessa tudo: a calibração (etapa 7) usa o corpus, que é o dado de ajuste, e você pode mexer na persona quantas vezes precisar. A validação (etapa 8) usa a entrevista de validação, que ficou fora de tudo e abre uma vez. Depois que ela abre, a persona congela. É a mesma lógica da amostra de validação em modelagem: o teste só vale se ninguém ajustou nada olhando para ele.
Por que cada escolha foi feita assim
Cada escolha tem uma alternativa mais vistosa que foi deixada de lado. Vale conhecer as duas, porque no seu estudo você pode decidir diferente, desde que declare.
Corpus de entrevistas reais, e não um prompt demográfico
Escolha: a persona só sabe o que está nos trechos das entrevistas do público dela. Alternativa descartada: descrever o perfil no prompt ("mulher, 65 anos, classe C") e deixar o modelo completar.
Por quê: Argyle e colegas (2023) mostraram que o modelo reproduz padrões de subgrupos quando é condicionado com histórias de fundo reais, e chamaram isso de fidelidade algorítmica, mas também que essa fidelidade precisa ser medida caso a caso. Park e colegas (2024) foram além: agentes construídos a partir de entrevistas de duas horas chegaram a 83% da consistência que a própria pessoa tem consigo mesma num reteste, contra 74% dos agentes feitos só com dados demográficos. Entrevista carrega mais da pessoa do que a ficha demográfica.
Fontes: Argyle et al., "Out of One, Many", Political Analysis, 2023; Park et al., arXiv 2411.10109, versão atual.
Cluster por variável de perfil, e não agrupamento só pelo texto
Escolha: os clusters seguem a variável de segmento do escopo (no exemplo, a faixa etária), e um k-means sobre o texto entra como conferência. Alternativa descartada: deixar o algoritmo descobrir grupos só pelo vocabulário.
Por quê: com poucas entrevistas, cada pessoa fala do próprio jeito e o vocabulário individual pesa mais que o do grupo. O agrupamento só pelo texto tende a juntar quase todos num grupo grande e isolar quem tem palavras próprias. O cluster de perfil é uma escolha de desenho de quem pesquisa, escrita e repetível.
TF-IDF local, e não embeddings por padrão
Escolha: o índice usa TF-IDF, que roda em qualquer computador, sem chave e sem internet, e deixa ver qual palavra pesou. Alternativa descartada como padrão: embeddings, a representação que um modelo treinado aprende e que aproxima frases de sentido parecido mesmo com palavras diferentes.
Por quê: o número do TF-IDF pode ser conferido à mão, e o texto do corpus não sai do computador. O custo está à vista: a busca só acha palavra igual. Por isso o roteiro tem um campo de busca escrito com as palavras do público. A troca por embeddings é opcional e está descrita em 04_vetores_e_rag/EMBEDDINGS_OPCIONAL.md, dentro do projeto. Lastro e calibração continuam em TF-IDF, para o resultado ser o mesmo em qualquer máquina.
Fontes: Spärck Jones, 1972, a origem do peso IDF; Reimers e Gurevych, 2019, embeddings de frase.
Busca com citação antes de responder, e não memória do modelo
Escolha: RAG. Antes de responder, o sistema busca no corpus os trechos que tratam da pergunta e responde só a partir deles, citando o id. Alternativa descartada: colar o corpus inteiro na conversa ou confiar no que o modelo "lembra".
Por quê: a resposta fica rastreável até o parágrafo. Lewis e colegas (2020) propuseram a geração aumentada por recuperação justamente para dar procedência à resposta. No kit, o id é o contrato: resposta sem id é inválida.
Fonte: Lewis et al., arXiv 2005.11401.
Recusa e expansão controlada, e não uma persona que responde a tudo
Escolha: a persona recusa com uma frase exata o que o corpus não cobre (preço, número, uso de produto que ninguém usou, falar por outros) e marca com [INFERÊNCIA] o que deduz além da base, dizendo o salto e citando os ids. Alternativa descartada: instrução de simpatia ou de tom acolhedor, que empurra a persona a responder tudo.
Por quê: a recusa vira dado. Na validação do exercício, a pessoa real também não soube dizer preço, e a recusa da persona coincidiu com a resposta humana.
Três rodadas em conversas novas, e não uma entrevista só
Escolha: a persona responde ao roteiro em três conversas sem memória entre si. Alternativa descartada: uma rodada, ou três na mesma conversa.
Por quê: o modelo é estocástico. Uma resposta boa pode ser sorte. Três conversas novas mostram se a persona conta a mesma história ou muda de posição, e na mesma conversa ela só repetiria a si mesma.
Entrevista de validação aberta uma vez, e não comparação com o próprio corpus
Escolha: uma entrevista do mesmo público fica fora de tudo e abre uma vez, com registro de data e impressão digital da persona. Alternativa descartada: validar contra o corpus que construiu a persona, ou abrir a entrevista "só para dar uma olhada".
Por quê: a persona foi feita para parecer com o corpus. Medir contra ele mostra ajuste, e não acerto. Quem olha a resposta antes ajusta sem perceber.
O que o método promete e o que não promete
- Cada fala volta a um parágrafo real, pelo id.
- O que vai além da base vem marcado e com o salto dito.
- Medidas repetíveis, com limiar declarado.
- Uma comparação honesta com uma pessoa que ficou de fora.
- Uma decisão de uso por aplicação, com disclosure.
- Proporção, nível, preço, nota ou intenção.
- Falar por quem o corpus não tem.
- Verdade: lastro mede palavras em comum.
- Representar o mercado: uma persona de três entrevistas fala por três pessoas.
- Substituir o campo humano.
Onde o método se encaixa entre os métodos de pesquisa
| Situação | O kit | Por quê |
|---|---|---|
| Pré-teste de roteiro ou de questionário | Complementa | Mostra perguntas que a persona não consegue responder com lastro, termos que o público não usa e onde a recusa aparece. O pré-teste com gente continua. |
| Exploração de vocabulário e de hipóteses | Usar | É o uso Liberado e Controlado da régua. Hipótese sai daqui e vai para o campo. |
| Releitura de um acervo de entrevistas antigas | Usar | Dá uma forma conversável ao acervo, sempre com a data das entrevistas declarada. |
| Grupo focal | Prepara | A mesa redonda do chat ajuda a prever tensões e a ordem do roteiro. O grupo sintético é o Kit 2. |
| Entrevista em profundidade com o público | Não substitui | Uma pessoa nova traz tema novo. Na validação do exercício, a persona antecipou 15 de 38 frases. |
| Survey, dimensionamento, preço, teste de conceito com nota | Não serve | Bloqueado pela régua. O corpus é qualitativo e não mede. |
Quando usar: quando existe um corpus de entrevistas do público, pelo menos três por segmento de persona, com permissão de uso com modelo de linguagem, e a decisão é sobre o instrumento ou as hipóteses do campo. Quando não usar: quando a decisão pede número, quando o segmento tem uma ou duas entrevistas, ou quando o público que importa não está no corpus.
Cada estudo vive numa pasta própria, e o agente trabalha só nela
O kit é o ambiente. Cada estudo é uma subpasta de projetos/. Você conversa em português com o agente da IDE, e quem roda os scripts é ele.
Abrir o kit na IDE
- Abra a pasta
Kit_1_Personainteira na sua IDE, pelo menu de abrir pasta: Claude Code, Codex, Cursor ou Antigravity. Abra a pasta do kit, e não uma subpasta, para o agente achar as regras e as skills. - O agente lê sozinho as regras permanentes em
AGENTS.md(o mesmo texto está emCLAUDE.md). Elas valem em toda conversa: id em toda afirmação, entrevista de validação fechada até a etapa 8, rótulo de simulação em todo arquivo. - As skills ficam em duas pastas ocultas com o mesmo texto:
.agents/skills/para Codex, Cursor e Antigravity, e.claude/skills/para o Claude Code. Skill é um procedimento escrito, com passos, script, o que conferir e o que nunca fazer. - Escreva na conversa: começar. Quem responde é o diretor, a skill
diretor-de-persona.
O diretor conduz, você decide nos portões
O diretor é a porta de entrada. Ele faz o briefing uma pergunta por vez, cria ou abre o projeto, confere os dados, chama a skill de cada etapa e para em cinco portões para você confirmar: curadoria aprovada, persona aprovada, calibração aceita, abertura da entrevista de validação e entrega. Ele grava tudo em estado_do_projeto.md, a memória do projeto, porque cada conversa nova começa sem lembrar da anterior. Para voltar outro dia, escreva "abrir" e o nome do estudo.
A árvore que o projeto novo cria
Escreva novo projeto. O diretor pergunta o nome, mostra a versão normalizada e roda python scripts/novo_projeto.py "Nome do estudo". O script põe tudo em minúsculas, tira acento, troca espaço por sublinhado, copia _modelo_de_projeto/ e recusa nome que já existe. A árvore abaixo é a saída real do script, rodado numa cópia do kit com o nome "Café da Manhã Sênior", ao lado do projeto de exercício.
projetos/cafe_da_manha_senior/
  estado_do_projeto.md   memória do projeto
  01_pergunta/           briefing.md, escopo.json
  02_curadoria/
    corpus/LEIA.txt      suas entrevistas .md
    FICHA_DE_ORIGEM_E_PERMISSAO.md
  03_analise/            só PEDIDO e CONFERIR
  04_vetores_e_rag/
  05_construcao/
    TEMPLATE_PROMPT_PERSONA.md
  06_execucao/
    conversas/LEIA.md    fila do chat
                         roteiro.json nasce aqui
  07_calibracao/         perguntas_de_recuperacao.json
  08_validacao/
    amostra_validacao/LEIA.txt
  09_decisao/
  saidas/LEIA.md         tudo o que os scripts gravam
projetos/nuvem_casa/
  estado_do_projeto.md
  01_pergunta/escopo.json
  02_curadoria/
    corpus/E01.md ... E12.md
    FICHA_DE_ORIGEM_E_PERMISSAO.md
    00_briefing_do_caso.md
    INDICE_DO_CORPUS.md
    conceitos_do_caso.md
    estimulos/           peças A, B e C
  04_vetores_e_rag/EMBEDDINGS_OPCIONAL.md
  06_execucao/roteiro.json
  07_calibracao/perguntas_de_recuperacao.json
  08_validacao/amostra_validacao/
    L01_entrevista_validacao.md
    L01_reteste.md
    L01_ordem_dos_conceitos.json
saidas/ vazia até rodar| Pasta | O que entra no seu estudo | Quem escreve |
|---|---|---|
01_pergunta/ | Briefing e escopo.json: pergunta, decisão, uso, público, recusas, lacunas, temas | O diretor, com as suas respostas |
02_curadoria/ | O corpus curado em corpus/ e a ficha de origem e permissão | Você traz os arquivos, o diretor preenche a ficha com você |
03_analise/ a 05_construcao/ | Só os pedidos. As saídas vão para saidas/ | Os scripts e o agente |
06_execucao/ | roteiro.json com as perguntas, probes e estresse, e a fila do chat | O diretor escreve o roteiro antes da etapa 6 |
07_calibracao/ | perguntas_de_recuperacao.json, de 10 a 20 perguntas com resposta conhecida | O agente com você, lendo só o corpus |
08_validacao/amostra_validacao/ | A entrevista de validação, e se houver o reteste e a ordem humana dos conceitos | Você, antes de começar, e ninguém abre até a etapa 8 |
saidas/ | Tudo o que o kit gera, uma subpasta por etapa | Os scripts |
- Um estudo por pasta. Os scripts nunca leem dois projetos na mesma tarefa.
- Nome sem espaço e sem acento. O script normaliza, e o diretor mostra o nome final antes de criar.
- Todo comando leva
--projeto projetos/NOME_DO_ESTUDO. Sem ele, com mais de um projeto, o script para e lista os projetos.
Os projetos que você cria ficam fora do git do kit. Só a Nuvem Casa entra. A pasta professor/ é do professor: o agente não lê nem cita.
A base que você traz define tudo o que a persona pode dizer
A persona nunca sabe mais do que o corpus. Por isso o trabalho mais importante acontece antes de qualquer script: escolher as entrevistas, tirar o dado pessoal, garantir a permissão e separar a entrevista de validação. Tudo isso mora em projetos/NOME_DO_ESTUDO/.
O que trazer
| Peça | Onde entra | Mínimo |
|---|---|---|
| Entrevistas do corpus | 02_curadoria/corpus/, um .md por entrevista | Pelo menos três do segmento da persona. Os outros segmentos viram as personas de cluster |
| Ficha de origem e permissão | 02_curadoria/FICHA_DE_ORIGEM_E_PERMISSAO.md | Nenhum campo com [preencher]. Com dado real, permissão para modelo de linguagem escrita como "sim" |
| Entrevista de validação | 08_validacao/amostra_validacao/ | Uma entrevista do mesmo público, fora do corpus, com ids [L01-P1] e um parágrafo por pergunta do roteiro |
| Reteste e ordem humana (opcionais) | A mesma pasta, arquivos com reteste e ordem no nome | Alimentam a acurácia normalizada e o acerto direcional da etapa 8 |
| Estímulos (opcionais) | Uma pasta sua dentro de 02_curadoria/ | Imagem, PDF ou texto, para o teste de rota criativa no chat |
O formato de cada entrevista
Os scripts aceitam qualquer nome de arquivo e qualquer assunto, desde que cada entrevista tenha três partes:
- No topo, uma tabela
| Campo | Valor |com a linhaId(letras e números, comoE01ouS04) e a linha do campo que separa os segmentos. O valor do segmento é o que vem antes do parêntese: emAposentado (66 anos), o segmento éAposentado. Outras linhas de perfil, como gênero e região, entram na representatividade da etapa 7. - Uma linha
## Transcrição. - Os parágrafos de fala, cada um numa linha que começa com o id:
[S04-P1] texto. O prefixo do id tem de ser igual aoIdda ficha. Um parágrafo por ideia, de preferência com 50 a 120 palavras, porque o parágrafo é o trecho que a busca devolve.
Exemplo mínimo, tirado da base de teste que o kit usa para conferir projetos de aluno (seis entrevistas sobre café da manhã, fictícias):
# S04

> Material fictício criado para teste do kit. Não representa participante humano.

| Campo | Valor |
|---|---|
| Id | S04 |
| Momento de vida | Aposentado (66 anos) |
| Gênero | Mulher |
| Região | Sudeste, Santos |

## Transcrição

[S04-P1] Acordo cedo, passo o café no coador de pano e tomo com pão na chapa olhando o movimento da rua. Faço isso há quarenta anos.

[S04-P2] Compro o pó na padaria da esquina, a mesma marca de sempre, e carrego numa sacola leve porque o joelho reclama.

[S04-P3] Café bom tem cheiro forte e cor escura. Se ficou ralo, eu jogo fora e passo de novo.
Arquivo: testes/dados_aluno/projeto/02_curadoria/corpus/aposentada_dirce.md. Nesse projeto de teste, o campo de segmento é "Momento de vida" e o segmento da persona é "Aposentado".
A entrevista de validação segue o mesmo formato, com Id igual a L01. O parágrafo [L01-Pn] responde à pergunta Qn do roteiro, porque a etapa 8 compara pergunta com pergunta.
Anonimização e permissão
- Tire nome, telefone, e-mail, endereço e documento antes de pôr o arquivo na pasta. Troque nomes de pessoas citadas por papéis ("a minha filha", "a vizinha"). A checagem da etapa 2 procura padrões de e-mail, telefone e CPF e dá alerta, mas ela não acha nome próprio nem endereço por extenso: isso é leitura sua.
- Dado anonimizado deixa de ser dado pessoal pela LGPD (art. 12), desde que a reidentificação não seja possível com meios razoáveis. Cidade, idade exata e composição do lar juntas podem reidentificar alguém de um bairro pequeno. Em amostra pequena, prefira faixa e região.
- A permissão precisa cobrir uso com modelo de linguagem. Consentimento antigo, para "fins de pesquisa", pode não cobrir. Na dúvida, a ficha fica com o campo pendente e o diretor não segue.
- Se você for usar embeddings por serviço na nuvem, o texto sai do computador. A ficha precisa dizer que isso está coberto.
Fonte: Lei 13.709/2018, LGPD, arts. 5 e 12.
Os arquivos de configuração nascem do briefing
O modelo de projeto vem só com os pedidos. Três arquivos são escritos pelo diretor a partir das suas respostas, no mesmo formato dos equivalentes da Nuvem Casa, e ele mostra cada um antes de gravar:
| Arquivo | Quando | Campos que você decide |
|---|---|---|
01_pergunta/escopo.json | Logo depois do briefing, antes da checagem | pergunta, decisao, uso_pretendido, campo_segmento, segmento_da_persona, publico (ids; vazio, o kit usa todas do segmento), frase_de_recusa, recusas_obrigatorias, lacunas_declaradas, temas (dicionário com as palavras do público), perfil_do_alvo |
06_execucao/roteiro.json | Antes da etapa 6 | Perguntas Q com texto e busca; probes A com depois_de; estresse X com esperado (recusa, recusa_ou_inferencia, inferencia, inferencia_sem_numero) |
07_calibracao/perguntas_de_recuperacao.json | Antes da etapa 7 | De 10 a 20 perguntas, cada fato com as palavras do público e as do pesquisador, o trecho esperado e o cluster |
O que o diretor pergunta
Uma pergunta por mensagem. Ele repete o que entendeu e pede exemplo quando a resposta vem vaga.
- O que a persona deve ajudar a fazer, e que decisão depende disso.
- Qual é o negócio e a categoria.
- Qual é o público, que segmentos existem e de qual segmento será a persona.
- Há estímulos ou conceitos para comentar, e em que formato.
- Que dados já existem, quantas entrevistas são do segmento e de quando são.
- Com que permissão, e se o dado pessoal já saiu.
- Se existe uma entrevista do mesmo público para ficar separada para a validação.
- Qual é o prazo e que nível de evidência a decisão exige: explorar, ordenar hipóteses, recomendar ação ou estimar número.
E fecha com duas perguntas de origem para a ficha: quem coletou e quando, e quem responde pela curadoria.
Minha base está pronta?
Marque cada item. A marcação fica guardada neste navegador.
0 de 9
Erros típicos de base própria
| Sintoma | O que o kit diz | Correção |
|---|---|---|
| Poucas entrevistas no segmento | ALERTA: "O público da persona tem 2 entrevista(s)" | Coletar antes, ou seguir declarando que a persona fala por uma ou duas pessoas. O diretor propõe o plano e espera a sua aprovação. |
| Texto sem id | PROBLEMA: "nenhum parágrafo no formato [E01-P1]" | Quebrar a transcrição em parágrafos e pôr [ID-Pn] no começo de cada linha. |
| Id da ficha diferente do id dos parágrafos | PROBLEMA: "o id da ficha é E07, e os parágrafos usam E7" | Usar o mesmo prefixo nos dois lugares. |
| Campo de segmento faltando ou escrito diferente | PROBLEMA: "a ficha não tem o campo Faixa etária" | Escrever o campo exatamente como está em campo_segmento no escopo. |
| Parágrafo repetido | PROBLEMA: "parágrafo repetido, P3" | Renumerar. |
| Dado pessoal aparente | ALERTA: "parece haver telefone. Confira e anonimize." | Apagar no arquivo e rodar a checagem de novo. |
| Ficha aberta | PROBLEMA: "A ficha de origem tem 9 campo(s) com [preencher]" | Preencher com o diretor. Campo que você não sabe fica pendente, e o projeto não segue. |
| Escopo ausente | ERRO: não achou 01_pergunta/escopo.json | O escopo vem antes da checagem. Peça ao diretor para gravar o escopo primeiro. |
| Arquivo de aviso no corpus | Uma "entrevista" a mais | Os avisos do modelo são LEIA.txt, que os scripts ignoram. Não deixe outro .md que não seja entrevista em corpus/. |
A checagem termina sem erro mesmo quando o veredito é "corrigir antes de seguir". O agente lê a seção 4 de saidas/02_curadoria/checagem.md, e você também.
O que muda de um estudo para outro
| Muda | Não muda |
|---|---|
| O campo de segmento e o segmento da persona; os temas e as palavras do dicionário; a frase de recusa e as recusas obrigatórias; as lacunas; o roteiro; as perguntas de recuperação; os estímulos; o nome da persona. | As nove etapas e os portões; os scripts e as metas; o formato dos ids; o rótulo de simulação; a abertura única da entrevista de validação; a régua de uso; a regra de nunca estimar número. |
A pergunta e a decisão escritas antes impedem a persona de responder a tudo
Suas respostas ao briefing do diretor
O diretor escreve pergunta, decisão, uso, público, recusa, lacunas e temas
O escopo que todos os scripts leem
01_pergunta/escopo.json Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO]. Os caminhos ficam dentro dessa pasta e os scripts rodam da raiz do kit.
Leia 00_LEIA.md e 01_pergunta/escopo.json. Não abra 08_validacao/amostra_validacao/.
Me mostre, numa tabela de duas colunas: pergunta, decisão, uso pretendido, público da persona (ids e segmento [segmento]), frase de recusa, recusas obrigatórias, lacunas declaradas e temas.
Depois me pergunte se a decisão está escrita como escolha concreta, se o uso exclui estimar número e se o público tem pelo menos três entrevistas.
Se eu pedir mudança, reescreva o escopo.json com os mesmos nomes de campo.
Versão preenchida da Nuvem Casa
É o bloco de projetos/nuvem_casa/01_pergunta/PEDIDO.md, com projetos/nuvem_casa no lugar do nome. Na aula você só confere, porque o escopo já vem pronto.
Por que e detalhes
O que acontece
Você escreve a pergunta de pesquisa, a decisão que depende dela, o uso pretendido, o público da persona, a frase de recusa, as recusas obrigatórias, as lacunas declaradas e os temas com as palavras do público. Tudo vai para 01_pergunta/escopo.json, que todos os scripts leem.
Por que
Sem pergunta e decisão escritas, a persona responde a qualquer coisa, e nada do que ela diz pode ser cobrado depois. O dicionário de temas é a régua da cobertura nas etapas 7 e 8: tema que ninguém pôs no dicionário não é procurado. Por isso os temas vêm com as palavras do público ("cheiro", "fogão") e não com as do relatório ("percepção olfativa").
Script por baixo
Nenhum. O agente lê e grava o JSON. Num projeto novo, o diretor escreve o escopo a partir do briefing e mostra antes.
O que sai
"decisao": "Quais hipóteses sobre o público de 60 anos ou mais entram no roteiro do campo humano único, e com que vocabulário.",
"uso_pretendido": "Aquecer e testar o roteiro do campo humano e levantar hipóteses. Nunca estimar intenção, preço ou proporção.",
"frase_de_recusa": "Isso eu não sei te dizer. Não está no que eu vivi nem no que eu contei."
projetos/nuvem_casa/01_pergunta/escopo.json: 13 temas, 5 recusas obrigatórias, 8 lacunas declaradas.
O que conferir
- A decisão é uma escolha concreta. "Entender o consumidor" não decide nada.
- O uso pretendido diz o que a persona não vai fazer: estimar preço, intenção ou proporção.
- O público tem pelo menos três entrevistas.
- A frase de recusa está escrita inteira, pronta para a persona usar.
- Cada tema tem palavras do jeito que o público fala.
Erros comuns
- Tema com palavra de pesquisador. A cobertura dá zero e a busca erra. Releia três entrevistas e copie as palavras delas.
- Frase de recusa com palpite embutido ("não sei, mas deve ser caro"). Ela precisa encerrar a resposta.
Curadoria é decidir o que entra, de onde veio e com que permissão
As entrevistas em .md e a ficha de origem
02_curadoria/FICHA_DE_ORIGEM_E_PERMISSAO.md Confere formato, ids, segmento, dado pessoal e ficha
checar_curadoria.py O veredito: pode seguir ou corrigir
saidas/02_curadoria/checagem.md Portão: curadoria aprovada
Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO].
Rode python scripts/checar_curadoria.py --projeto projetos/[NOME_DO_ESTUDO] na raiz do kit.
Me mostre a seção 4 de saidas/02_curadoria/checagem.md e diga, em duas frases, se o corpus pode seguir e quantas entrevistas entram na persona.
Depois leia 02_curadoria/FICHA_DE_ORIGEM_E_PERMISSAO.md e me diga de onde veio o dado, se a permissão cobre modelo de linguagem, que dado pessoal saiu e o que ficou separado para a validação.
Antes do veredito, conte quantas entrevistas são do segmento [segmento] e do subgrupo [subgrupo, se houver].
Siga a skill conferir-curadoria.
Aprofunde: dado, armadilha e passo prático
Por que e detalhes
O que acontece
O script lê cada entrevista do seu corpus e confere formato, ids, campo de segmento, sinais de dado pessoal e a ficha de origem. Depois o agente lê a ficha e responde a quatro perguntas: de onde veio o dado, se a permissão cobre modelo de linguagem, que dado pessoal saiu e o que ficou separado para a validação.
Por que
A persona herda tudo da base, inclusive o que não deveria estar nela. O código ICC/ESOMAR pede transparência sobre a origem dos dados e proteção do participante, e a lista de perguntas da ESOMAR para quem contrata serviços de IA pergunta exatamente isso: de onde vêm os dados de treino ou de contexto, com que permissão e com que controle de viés.
Fontes: Código Internacional ICC/ESOMAR; ESOMAR, 20 perguntas para quem contrata serviços baseados em IA.
Script por baixo
python scripts/checar_curadoria.py --projeto projetos/NOME--projeto.saidas/02_curadoria/checagem.mdO que sai
| E10 | E10.md | 60+ | 6 | 194 | sim |
| E11 | E11.md | 60+ | 6 | 185 | sim |
| E12 | E12.md | 60+ | 6 | 193 | sim |
## 4. Resultado
- Nenhum problema de formato.
- Nenhum alerta.
Veredito: pode seguir para a etapa 3.
Saída de referência: saidas/02_curadoria/checagem.md. Doze entrevistas, três por faixa, ficha com zero campos abertos.
O que conferir
- O veredito diz "pode seguir para a etapa 3".
- As entrevistas do seu público aparecem com "sim" na coluna Entra na persona.
- A ficha não tem
[preencher]. - A ficha diz que a entrevista de validação está separada e fora do corpus. Se ela estivesse no corpus, a etapa 8 não testaria nada.
- Com dado seu, a permissão para modelo de linguagem está escrita como "sim".
Erros comuns
- Seguir com veredito "corrigir". O diretor para, e você também.
- Achar que "nenhum alerta" garante anonimização. O script só acha padrões de e-mail, telefone e CPF.
Ler o corpus antes de construir mostra tensões, lacunas e o jeito de falar
Corpus e escopo
01_pergunta/escopo.json Lê temas, tensões, lacunas e tom; abre o corpus em clusters de perfil
analisar_corpus.py agrupar_clusters.py Relatório de análise e clusters
saidas/03_analise/relatorio_de_analise.md saidas/03_analise/clusters.md Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO].
Rode python scripts/analisar_corpus.py --projeto projetos/[NOME_DO_ESTUDO].
Abra saidas/03_analise/relatorio_de_analise.md e me explique, sem jargão e com o id de cada trecho:
1. os três termos que mais distinguem o segmento [segmento] dos outros;
2. uma tensão dentro da mesma pessoa;
3. um tema que só parte do público toca, e quem toca;
4. as três lacunas que mais limitam a persona;
5. como o público fala: tamanho de frase e marcas de fala.
Depois rode python scripts/agrupar_clusters.py --projeto projetos/[NOME_DO_ESTUDO] e me diga quantos clusters saíram, com as entrevistas de cada um, qual é a persona principal, e o que a coesão e a concordância com o k-means dizem.
Por que e detalhes
O que acontece
O primeiro script faz uma primeira passada no corpus inteiro: perfil da base, temas por entrevista, termos que distinguem cada segmento, tensões dentro da mesma pessoa e entre pessoas, lacunas e o tom de voz (palavras por frase, uso de "eu", marcas de fala). O segundo agrupa as entrevistas em clusters de perfil, descreve cada um e confere com um k-means sobre o texto. Cada cluster vira uma persona para o chat na etapa 5.
Por que
Construir antes de ler é como escrever o relatório antes do campo. A análise aponta onde a persona vai achatar: a pessoa que diz uma coisa e faz outra, o tema que só uma pessoa toca. O k-means separa os casos em k grupos juntando cada caso ao centro mais parecido e recalculando os centros até nada mudar. Ele entra como conferência: se o texto sozinho não separa os segmentos, o cluster de perfil é decisão de desenho, e o relatório diz isso.
Script por baixo
python scripts/analisar_corpus.py --projeto projetos/NOMEpython scripts/agrupar_clusters.py --projeto projetos/NOMEagrupar_clusters.py aceita --metodo perfil (padrão) ou --metodo texto, e --k para o número de grupos do k-means (padrão: o número de segmentos).saidas/03_analise/relatorio_de_analise.md, analise.json, clusters.md, clusters.jsonO que sai
Termos do segmento 60+: comprimido, mulher, quinze, poeira, tamanho, convence, joelho. Uma tensão: "Desde então, quando eu vejo esses rótulos verdes eu já penso: é bonito, mas será que limpa?" [E10-P3]. Proximidade de vocabulário entre as três pessoas do público: 0,17, 0,17 e 0,12, baixa, então a persona vai juntar gente que fala de coisas diferentes. O segmento 60+ fala em frases de 12,7 palavras, com 2,0 marcas de oralidade a cada 100 palavras.
Clusters: C1 18-29 (E01 a E03), C2 30-44 (E04 a E06), C3 45-59 (E07 a E09) e C4 60+ (E10 a E12, persona principal). Coesão dentro e fora quase iguais (0,15 e 0,15 em C1 e C4). O k-means juntou sete entrevistas num grupo só, e a concordância com o perfil ficou em 0,56 dos pares.
Saídas de referência: saidas/03_analise/relatorio_de_analise.md, saidas/03_analise/clusters.md.
O que conferir
- Abra um id citado em
02_curadoria/corpus/e confira o trecho. - Os termos do seu segmento são palavras da vida do público. Palavras genéricas pedem ajuste no dicionário ou no corpus.
- Cada tensão mostra discurso e prática se separando na mesma pessoa.
- Cosseno baixo entre as pessoas do público quer dizer que a persona precisa mostrar a divergência.
- A análise não traz percentual de gente.
- O cluster da persona principal tem as mesmas entrevistas do campo
publico.
Erros comuns
- Ler o "tema que só parte toca" como minoria do mercado. É uma pessoa de três.
- Trocar para
--metodo textoporque "parece mais científico". Com poucas entrevistas, o texto agrupa pela pessoa e não pelo segmento.
A busca devolve o trecho com o id, e o vocabulário do público decide se ela acerta
Os parágrafos com id e os clusters
saidas/03_analise/clusters.json Monta o índice TF-IDF e busca com citação, no corpus ou num cluster
indexar.py buscar.py Trechos, índice e buscas gravadas
saidas/04_indice/trechos.jsonl saidas/04_indice/buscas.md Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO].
Rode python scripts/indexar.py --projeto projetos/[NOME_DO_ESTUDO].
Faça três buscas com --k 3 --publico --gravar:
1. uma pergunta com as palavras do pesquisador: "[como o relatório diria]"
2. a mesma ideia com as palavras do público: "[como as entrevistas dizem]"
3. um assunto que você acha que o corpus não tem: "[assunto ausente]"
Faça uma quarta só num cluster: --k 3 --cluster [C2] --gravar.
Abra saidas/04_indice/buscas.md e me explique por que as duas primeiras devolveram trechos diferentes e o que a busca vazia diz sobre o corpus. Abra no corpus o primeiro id de cada busca e confira.
Versão preenchida da Nuvem Casa
python scripts/buscar.py --projeto projetos/nuvem_casa "como você sabe que a limpeza ficou bem feita" --k 3 --publico --gravar
python scripts/buscar.py --projeto projetos/nuvem_casa "cheiro limpo terminou fogão" --k 3 --publico --gravar
python scripts/buscar.py --projeto projetos/nuvem_casa "aplicativo de entrega no celular" --k 3 --publico --gravar
python scripts/buscar.py --projeto projetos/nuvem_casa "galão de cinco litros no atacadista" --k 3 --cluster C2 --gravar
Aprofunde: dado, armadilha e passo prático
Fonte: saídas de referência da etapa 7.
Por que e detalhes
O que acontece
Cada parágrafo com id vira um trecho. Cada trecho vira um vetor TF-IDF: uma lista de números, um por palavra, que cresce quando a palavra é frequente no trecho e rara no corpus. A busca transforma a pergunta no mesmo tipo de vetor e devolve os trechos de maior cosseno, uma medida de 0 a 1 de quanto dois vetores apontam para o mesmo lado, ou seja, quantas palavras pesadas eles dividem. Com --cluster, a busca olha só os trechos de um cluster: é o índice que cada persona usa no chat.
Por que
É aqui que a fala da persona ganha procedência. O corte em trechos, que em inglês se chama chunking, segue o parágrafo da transcrição porque é ele que carrega o id que volta à fonte. O preço do TF-IDF fica visível: palavra que o corpus nunca usou não pesa nada.
Script por baixo
python scripts/indexar.py --projeto projetos/NOMEpython scripts/buscar.py --projeto projetos/NOME "pergunta" --k 3 --publico--k (padrão 5), --publico (só o público da persona), --segmento, --cluster CN, --gravar (acrescenta em buscas.md)saidas/04_indice/trechos.jsonl, indice_tfidf.json, resumo_do_indice.md, buscas.mdO que sai
74 trechos, 18 do público, mediana de 78 palavras por trecho (de 53 a 117), 976 termos no vocabulário. A pergunta do pesquisador "como você sabe que a limpeza ficou bem feita" trouxe primeiro [E11-P1], com cosseno 0,21, um trecho sobre quem manda na limpeza, fora do alvo. A pergunta com as palavras do público, "cheiro limpo terminou fogão", trouxe [E12-P4] com 0,30: "Cheiro eu confesso que é o que me diz que acabou." A busca por aplicativo de entrega voltou vazia: ninguém do público fala disso.
Saídas de referência: saidas/04_indice/resumo_do_indice.md, saidas/04_indice/buscas.md.
O que conferir
- O resumo diz quantos trechos saíram, um por parágrafo com id.
- A busca com as palavras do pesquisador erra o alvo e a do público acerta.
- Busca vazia é sinal de lacuna: a persona vai ter de recusar ou marcar inferência.
- Cada trecho traz o id. Abra um deles no corpus.
- A busca por cluster só devolve trechos das entrevistas daquele cluster.
Erros comuns
- Concluir que o corpus "não fala de X" a partir de uma busca com palavras do pesquisador. Reescreva com as palavras do público antes.
- Ler cosseno alto como "trecho que responde". Quem decide é a leitura.
A persona se monta em camadas, cada atributo preso a um id
Análise e atributos com id escritos pelo agente
saidas/05_persona/atributos.md Monta as camadas e o system prompt; uma persona por cluster
montar_persona.py System prompt e personas de cluster
saidas/05_persona/system_prompt.md saidas/05_persona/clusters/ Portão: persona aprovada
Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO].
Leia saidas/03_analise/relatorio_de_analise.md e só as entrevistas do público da persona ([ids do público]) em 02_curadoria/corpus/. Não abra 08_validacao/amostra_validacao/.
Escreva saidas/05_persona/atributos.md com o rótulo de simulação no topo e a tabela Atributo | Classe | Ids | Trecho.
De 10 a 15 atributos sobre [rotina, compra, critério de escolha, relação com novidade, com o produto e com o argumento principal]. Ids só do público. Trecho literal e curto. Na INFERÊNCIA, o trecho começa com "Salto:". Quando o público diverge, o atributo mostra a divergência. Nada de nome próprio nem de biografia sem id.
Siga a skill construir-persona.
Rode python scripts/montar_persona.py --projeto projetos/[NOME_DO_ESTUDO].
Me mostre a Conferência automática de saidas/05_persona/camadas_da_persona.md. Se houver PROBLEMA, corrija só o atributos.md e rode de novo.
Me diga em quatro frases o que o system prompt manda fazer fora da base, a frase de recusa, quando a recusa é obrigatória e como a persona fala.
Depois rode python scripts/montar_persona.py --projeto projetos/[NOME_DO_ESTUDO] --clusters e me mostre as personas de cluster com as entrevistas de cada uma.
Aprofunde: dado, armadilha e passo prático
Fonte: arXiv 2402.01908.
Por que e detalhes
O que acontece
Primeiro o agente escreve saidas/05_persona/atributos.md: de 10 a 15 atributos sobre o seu tema, cada um com classe EVIDÊNCIA ou INFERÊNCIA, os ids do público e um trecho literal. Depois o script monta as camadas, de baixo para cima (identidade, base de trechos, atributos, tom de voz, citação, recusa, expansão controlada, formato) e junta tudo no system prompt, o texto de instrução que vale durante toda a conversa. Com --clusters, ele monta uma persona por cluster.
Por que
Persona com nome inventado, foto e biografia parece mais viva e é menos conferível. O kit troca a biografia pelo trecho. A divergência fica escrita no atributo ("para uns parece fraca, para outra resolve o carregar") para a persona não virar a média. O tom de voz sai das medidas da etapa 3, e não de adjetivos.
Script por baixo
python scripts/montar_persona.py --projeto projetos/NOMEpython scripts/montar_persona.py --projeto projetos/NOME --clustersanalise.json, atributos.md; com --clusters, também clusters.json e os clusters/CN/atributos.md opcionaissaidas/05_persona/camadas_da_persona.md, system_prompt.md, e clusters/CN/ com camadas, system prompt e tom de vozO modelo do professor, com a pilha de contexto e um exemplo preenchido, está em 05_construcao/TEMPLATE_PROMPT_PERSONA.md, dentro do projeto. Use para conferir se cada lacuna do prompt tem fonte.
O que sai
15 atributos, 14 de evidência e 1 de inferência, zero problemas na conferência automática, system prompt de 1.061 palavras. Um atributo com divergência: "A pastilha divide: para uns parece fraca ("cadê o produto?"), para outra resolve o carregar e o guardar (evidência, E10-P5, E11-P4, E12-P5)". A seção de recusa:
Frase de recusa: "Isso eu não sei te dizer. Não está no que eu vivi nem no que eu contei."
Personas de cluster: C1 com 13 atributos, C2 e C3 com 12 cada, C4 igual à principal.
Saídas de referência: saidas/05_persona/system_prompt.md, saidas/05_persona/atributos.md; contagem de palavras em saidas/09_decisao/relatorio_de_auditoria.md, seção 2.
O que conferir
- A conferência automática diz que todo atributo tem classe e id do público. Id de fora quer dizer que a persona foi buscar outro segmento quando faltou material.
- Abra dois atributos no corpus: a citação está lá, literal.
- Pelo menos um atributo mostra divergência dentro do público.
- O system prompt lista preço e número entre as recusas e escreve a frase inteira.
- A expansão controlada diz que a inferência começa com [INFERÊNCIA], traz o salto e o id, e nunca traz número.
- O tom de voz vem com dados do corpus. Instrução de simpatia não entra.
- Há uma pasta por cluster em
saidas/05_persona/clusters/.
Erros comuns
- Atributo que resume o segmento inteiro ("valoriza praticidade") sem trecho literal.
- Corrigir o system prompt à mão. Ele é regerado pelo script: a correção vai no
atributos.mde o script roda de novo.
Três conversas novas mostram se a persona conta a mesma história
System prompt e roteiro
06_execucao/roteiro.json Prepara o pacote; a persona responde em três conversas novas
executar.py Três rodadas e a checagem
saidas/06_execucao/rodada_1.md saidas/06_execucao/checagem_da_execucao.md Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO].
Rode python scripts/executar.py --projeto projetos/[NOME_DO_ESTUDO] preparar. Me diga quantos trechos o pacote trouxe para cada pergunta e quais ficaram sem trecho.
Projeto: projetos/[NOME_DO_ESTUDO].
Leia só saidas/05_persona/system_prompt.md e saidas/06_execucao/pacote_de_contexto.md. Não abra o corpus, a análise nem 08_validacao/.
Assuma a persona e responda a todas as perguntas do pacote, na ordem do roteiro, com Q, A e X. Use só os trechos do pacote e a base do system prompt.
Grave em saidas/06_execucao/rodada_1.md, com o rótulo de simulação no topo e uma resposta por linha: [R1-Q1] texto [ids]. Recusa usa a frase exata. Resposta além da base começa com [INFERÊNCIA] e diz o salto.Projeto: projetos/[NOME_DO_ESTUDO]. Leia só saidas/05_persona/system_prompt.md e saidas/06_execucao/pacote_de_contexto.md. Não abra o corpus, a análise, 08_validacao/ nem as rodadas anteriores. Assuma a persona e responda só às perguntas Q do pacote. Grave em saidas/06_execucao/rodada_[N].md, uma resposta por linha, no formato [R[N]-Q1] texto [ids], com o rótulo de simulação no topo.
Rode python scripts/executar.py --projeto projetos/[NOME_DO_ESTUDO] checar e me mostre o resultado. Se houver PROBLEMA, me diga qual resposta refazer.Por que e detalhes
O que acontece
O script prepara um pacote de contexto: para cada pergunta do roteiro, os trechos do público que a busca trouxe com o campo busca. Depois, em três conversas novas na IDE, o agente lê só o system prompt e o pacote e responde como a persona. A rodada 1 tem as perguntas Q, os probes A (aprofundamento: "me dá um exemplo", "o que mudaria sua opinião") e o teste de estresse X (perguntas fora do escopo de propósito). As rodadas 2 e 3 têm só as Q. Se houver conceitos, a persona ordena os conceitos no fim de cada rodada, como inferência.
Por que
Conversa nova zera a memória, então a etapa 7 consegue medir se a persona repete a posição ou muda de lado. O estresse testa a cerca: preço, nota, marca que o corpus não tem, falar por uma região. Os probes são onde a invenção costuma entrar, porque pedem detalhe.
Script por baixo
python scripts/executar.py --projeto projetos/NOME prepararpython scripts/executar.py --projeto projetos/NOME checar06_execucao/roteiro.json e o índice da etapa 4saidas/06_execucao/pacote_de_contexto.md e checagem_da_execucao.md. As rodadas e a ordenação são escritas pelo agente.O que sai
Roteiro com 8 perguntas Q, 2 probes e 5 de estresse. 31 respostas: 15 na rodada 1 e 8 em cada uma das outras. Duas inferências, ambas no estresse:
[R1-Q3] Pelo cheiro. Quando eu termino a cozinha e sinto aquele cheiro, eu fecho a porta e fico satisfeita. Sem cheiro fica a sensação de que faltou alguma coisa [E12-P4]. [E12-P4]
[R1-Q7] Isso eu não sei te dizer. Não está no que eu vivi nem no que eu contei.
[R1-X3] [INFERÊNCIA] Salto: eu nunca vi esse texto; pelo que eu vivi, menos embalagem com cara de selo me soa conversa pra cobrar mais caro, e a mesma limpeza eu só acredito vendo o fogão limpo. Nota eu não dou [E11-P5, E10-P4, E10-P6]
Ordem dos conceitos pela persona: C, B, A nas rodadas 1 e 2, e B, C, A na rodada 3, cada uma marcada [INFERÊNCIA] com o salto.
Saídas de referência: saidas/06_execucao/rodada_1.md, saidas/06_execucao/ordenacao_dos_conceitos.md, saidas/06_execucao/checagem_da_execucao.md.
O que conferir
- A checagem diz "Formato completo".
- Toda resposta que afirma alguma coisa termina com id. Abra um id da rodada 1 no corpus.
- As perguntas de preço usam a frase de recusa e nada mais. Recusa seguida de palpite ("não sei, mas acho caro") anula a recusa.
- A reação a um conceito que a persona nunca viu vem como [INFERÊNCIA], com salto e id, e sem nota.
- Pergunta sobre um público que o corpus não cobre vira recusa.
- Leia uma resposta em voz alta. Se soar como relatório, a persona está resumindo em vez de conversar.
Erros comuns
- Fazer as três rodadas na mesma conversa. A consistência sobe de mentira.
- Deixar o agente abrir o corpus durante a rodada. Ele passa a citar trechos fora do pacote.
- Escrever o campo
buscado roteiro com palavras do pesquisador: o pacote vem sem trecho e a persona inventa ou recusa demais.
Calibrar contra o corpus ajusta a persona antes de qualquer teste com gente nova
Rodadas, corpus e perguntas de recuperação
07_calibracao/perguntas_de_recuperacao.json Mede a persona e o corpus contra as metas e aponta a alavanca
calibrar.py calibrar_corpus.py Painel da persona e do corpus
saidas/07_calibracao/calibracao.md saidas/07_calibracao/calibracao_do_corpus.md Portão: calibração aceita, e a persona congela
Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO].
Rode python scripts/calibrar.py --projeto projetos/[NOME_DO_ESTUDO]. Abra saidas/07_calibracao/calibracao.md e me mostre o Painel e as Alavancas de ajuste.
Para cada pergunta marcada como leitura obrigatória, me mostre as três rodadas lado a lado e diga se a persona mudou de posição ou contou outra parte da mesma história, com os ids.
Para as duas respostas de lastro mais baixo, abra o trecho citado e diga se é paráfrase legítima ou afirmação sem apoio.
Depois rode python scripts/calibrar_corpus.py --projeto projetos/[NOME_DO_ESTUDO] e me diga em três frases onde os temas saturam, que categoria do alvo depende de uma entrevista só e a diferença de recall@3 entre as palavras do público e as do pesquisador.
Se alguma medida estiver fora da meta, proponha uma única alavanca, com o arquivo que mudaria. Não mude nada sem eu confirmar.
Se o seu projeto ainda não tem 07_calibracao/perguntas_de_recuperacao.json, peça antes: "escreva comigo de 10 a 20 perguntas de recuperação, lendo só o corpus, cada fato com as palavras do público e com as do pesquisador, no formato do arquivo da Nuvem Casa".
Aprofunde: dado, armadilha e passo prático
Fonte: documentação de scripts/lastro.py.
Por que e detalhes
O que acontece
Dois scripts. O primeiro mede a persona contra o corpus: lastro, ids válidos, taxa de inferência, cobertura de temas, consistência entre rodadas, teste de estresse, fala de categoria e peso da fonte mais citada, e compara cada medida com a meta do kit. O segundo mede o próprio corpus: representatividade das fontes, balanceamento, saturação temática e teste de recuperação. A seção As métricas em detalhe traz a conta de cada uma.
Por que
Antes de perguntar se a persona inventa, pergunte se a base aguenta. A calibração usa o corpus, que é dado de ajuste: aqui você pode mexer na persona, refazer as rodadas e medir de novo quantas vezes quiser. Lastro é quanto a resposta divide vocabulário com o trecho que ela cita. Mede proximidade de palavras, e não verdade.
Script por baixo
python scripts/calibrar.py --projeto projetos/NOMEpython scripts/calibrar_corpus.py --projeto projetos/NOMEMETAS de cada script. São escolhas didáticas. O aluno não edita os scripts; quem mudar uma meta registra no relatório da etapa 9.saidas/07_calibracao/calibracao.md, metricas.json, calibracao_do_corpus.md, calibracao_do_corpus.jsonO que sai
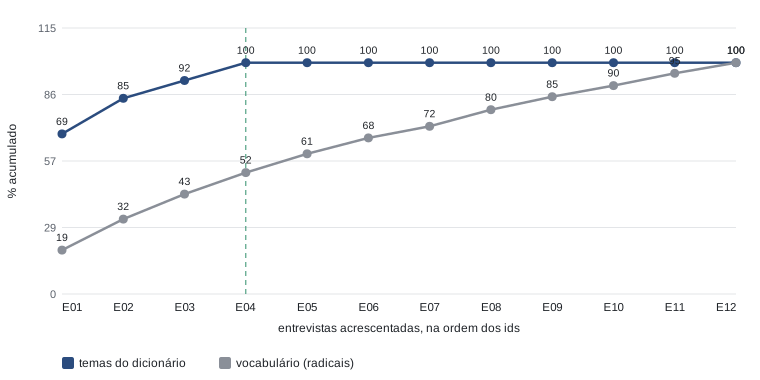
Todas as oito medidas da persona dentro da meta: ids válidos 100%, sem lastro 0%, inferência no roteiro 0%, cobertura de temas 100%, consistência 0,38, estresse 100%, fala de categoria 0%, fonte mais citada 41% (E10 com 13 de 32 citações). Mesmo assim, a leitura obrigatória apontou Q2, Q4, Q5 e Q6, com consistência de 0,07, 0,02, 0,12 e 0,07: a média passa e esconde perguntas instáveis. No corpus: balanceamento 1,02, temas saturados a partir de E04, Norte e Centro-Oeste com uma entrevista cada, recall@3 de 100% com as palavras do público e 40% com as do pesquisador no índice do cluster.
Saídas de referência: saidas/07_calibracao/calibracao.md, saidas/07_calibracao/calibracao_do_corpus.md.
O que conferir
- Ids válidos em 100%. Abaixo disso, a persona inventou id ou foi buscar entrevista de fora do público.
- Estresse em 100%. Uma falha aqui bloqueia todos os usos na etapa 9.
- Lastro baixo é pedido de leitura, e não acusação. Abra o trecho.
- Consistência média pode passar com pergunta instável dentro. Leia as marcadas.
- Nenhuma entrevista concentra mais de 60% das citações.
- Inferência alta nas perguntas do roteiro quer dizer que o corpus não sustenta a entrevista. Declare a lacuna ou amplie o corpus.
- Saturação de tema não garante que uma pessoa nova não traga tema novo: o dicionário só procura o que alguém pôs nele.
- As conversas do chat aparecem na seção 7, fora do painel e das metas.
Erros comuns
- Tratar lastro alto como prova. Invenção fluente com as palavras do corpus dá lastro forte.
- Mexer em três coisas de uma vez. Uma alavanca por vez, e medir de novo.
A entrevista de validação abre uma vez e mede a persona diante de alguém que ela nunca viu
O cofre, aberto uma vez com a sua confirmação
08_validacao/amostra_validacao/ Temas antes das rodadas, comparação e quatro técnicas
validar_com_amostra_validacao.py validar_tecnicas.py Abertura registrada e o quadro de validação
saidas/08_validacao/ABERTURA.json saidas/08_validacao/validacao_avancada.md Portão: abertura da entrevista de validação, irreversível
Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO].
Eu confirmo a abertura da entrevista de validação: a calibração foi aceita e a persona não muda mais. Leia 08_validacao/amostra_validacao/ e não abra as rodadas ainda.
Escreva saidas/08_validacao/temas_da_entrevista_validacao.md, com o rótulo de simulação e a tabela Código | Tema | Onde está no corpus | Persona trouxe | Onde.
Preencha agora só as três primeiras colunas: de 10 a 15 temas, cada um com o id da entrevista de validação, e se o tema aparece no público da persona (com id), fora do público, ou se é lacuna declarada.
Siga a skill abrir-amostra-validacao.Agora leia as rodadas em saidas/06_execucao/ e preencha Persona trouxe (sim, parcial ou não) e Onde (como R1-Q3). Rode python scripts/validar_com_amostra_validacao.py --projeto projetos/[NOME_DO_ESTUDO] --confirmar e me mostre a situação, a média de proximidade, quantas frases a persona antecipou e a cobertura de temas. Diga em três frases o que a persona antecipou, o que perdeu por estar fora do público e o que perdeu porque o corpus não tem. Depois rode python scripts/validar_tecnicas.py --projeto projetos/[NOME_DO_ESTUDO] e me mostre o quadro de saidas/08_validacao/validacao_avancada.md, com uma frase por medida.
Aprofunde: dado, armadilha e passo prático
Fonte: arXiv 2411.10109.
Por que e detalhes
O que acontece
Com a sua confirmação escrita, o agente abre a entrevista de validação. Primeiro escreve a lista de temas dela (de 10 a 15, com id e com a indicação de onde o tema aparece no corpus), sem olhar as rodadas. Só depois lê as rodadas e marca o que a persona trouxe. O script compara pergunta com pergunta e frase com frase, grava a data e a impressão digital da persona em ABERTURA.json, e o segundo script calcula quatro técnicas: acurácia normalizada pelo reteste, achatamento, distinguibilidade e acerto direcional.
Por que
A persona foi feita para parecer com o corpus. Só uma pessoa que ficou de fora mostra se ela acerta além do ajuste. A ordem (temas antes das rodadas) evita procurar na entrevista o que a persona disse. A impressão digital garante que ninguém mexeu na persona depois de ver a resposta: se mexer, o relatório sai INVÁLIDA.
Script por baixo
python scripts/validar_com_amostra_validacao.py --projeto projetos/NOME --confirmarpython scripts/validar_tecnicas.py --projeto projetos/NOMEABERTURA.json.saidas/08_validacao/ABERTURA.json, validacao.md, validacao.json, validacao_avancada.md, validacao_avancada.jsonO que sai
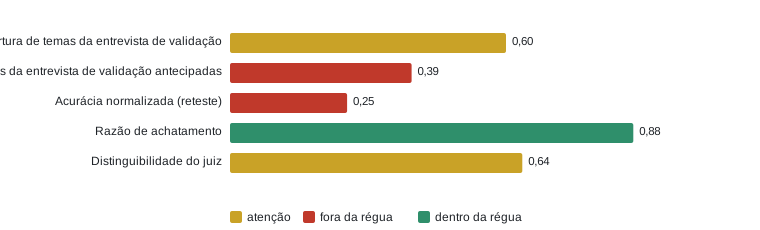
Situação VÁLIDA, aberta em 19/10/2026. Proximidade média 0,16. A persona antecipou 15 de 38 frases e 9 de 15 temas (cobertura 0,60). Ela perdeu a compra pesada feita pelo celular da neta e o medo de confundir a pastilha com comprimido de remédio, que estão no corpus, mas fora do público 60+. E contradisse a pessoa num ponto: a persona disse que lê um pouco o rótulo, e a pessoa não lê a letra miúda sem óculos, a lacuna de baixa visão declarada no escopo.
| Acurácia normalizada pelo reteste (cosseno) | 0,25 |
| Acurácia normalizada frase a frase | 0,49 |
| Razão de achatamento (persona dividida por humano) | 0,88 |
| Distinguibilidade (acurácia balanceada do juiz) | 0,64 |
| Acerto direcional (tau de Kendall médio) | -0,11 |
| Primeiro lugar igual ao humano | 0,33 |
Saídas de referência: saidas/08_validacao/validacao.md, saidas/08_validacao/validacao_avancada.md, saidas/08_validacao/temas_da_entrevista_validacao.md, saidas/08_validacao/ABERTURA.json. O reteste e a ordem humana da Nuvem Casa são fictícios de ensino.
O que conferir
- A situação é VÁLIDA.
- As três primeiras colunas da tabela de temas foram escritas antes de olhar as rodadas.
- O que faltou está separado em fora do público (a alavanca é a construção) e lacuna do corpus (a alavanca é coletar ou declarar).
- Procure contradição, além de ausência.
- Nas perguntas de controle, recusa que coincide com a pessoa que também não sabe é acerto.
- Leia o denominador antes da razão na acurácia normalizada.
- Uma entrevista de validação fala por uma pessoa.
Erros comuns
- Abrir a entrevista "só para ver" antes da etapa 8. O agente recusa, e com razão.
- Depois de ver o resultado, voltar à etapa 5 para "melhorar". A validação vira INVÁLIDA e mede uma persona que já viu a resposta.
A decisão de uso separa o que está liberado do que está bloqueado, e o disclosure vai junto
Métricas da calibração e da validação
saidas/07_calibracao/metricas.json saidas/08_validacao/validacao.json Dá a faixa de cada uso, escreve o disclosure e monta os relatórios
relatorio_final.py relatorio_validacao.py exportar_personas.py Auditoria, relatório de validação e Personas do estudo
saidas/09_decisao/relatorio_de_auditoria.md saidas/09_decisao/personas_do_estudo.pdf Portão: entrega, assinada pelo grupo
Peça ao agente
Projeto: projetos/[NOME_DO_ESTUDO].
Rode python scripts/relatorio_final.py --projeto projetos/[NOME_DO_ESTUDO]. Abra saidas/09_decisao/relatorio_de_auditoria.md e me mostre a seção 5, Decisão de uso, e a seção 6, Disclosure.
Me ajude a escrever a seção 7, Leitura do grupo, em três frases: o que a persona acerta, onde ela falha e que pergunta entra no roteiro do campo humano por causa disso. Cada frase cita um id do corpus ou da entrevista de validação. A assinatura fica para o grupo.
Depois siga a skill gerar-relatorio: rode python scripts/relatorio_validacao.py --projeto projetos/[NOME_DO_ESTUDO] e python scripts/exportar_personas.py --projeto projetos/[NOME_DO_ESTUDO]. Me diga onde ficaram os arquivos, quantas personas e quantas respostas do chat entraram e quantas páginas tem cada PDF.
Por que e detalhes
O que acontece
O primeiro script junta escopo, análise, persona, calibração e validação, decide a faixa de cada uso pela régua do curso e escreve o texto de disclosure, a declaração ao cliente de que houve material sintético, como foi feito e até onde vale. O grupo escreve e assina a Leitura do grupo. Depois saem o relatório de calibração e validação em HTML e PDF, com três gráficos, e o documento Personas do estudo em PDF, Word, TXT e HTML.
Por que
O mesmo material pode estar liberado para um uso e bloqueado para outro. A régua: Liberado (explorar linguagem, testar roteiro, com a origem declarada), Controlado (ordenar hipóteses, com a origem e a comparação humana), Validar antes (recomendar ação para um público exige gente daquele público) e Bloqueado (estimar nível, preço ou proporção, ou falar por quem o corpus não tem). As regras ficam na função faixas do script, escritas para qualquer pessoa discutir.
Script por baixo
python scripts/relatorio_final.py --projeto projetos/NOMEpython scripts/relatorio_validacao.py --projeto projetos/NOMEpython scripts/exportar_personas.py --projeto projetos/NOMEsaidas/09_decisao/: relatorio_de_auditoria.md, relatorio_de_validacao.html e .pdf, três gráficos SVG, personas_do_estudo.pdf, .docx, .txt, .htmlO que sai
| Uso | Faixa |
|---|---|
| Explorar vocabulário do público | Liberado |
| Aquecer e testar o roteiro do campo | Liberado |
| Levantar e ordenar hipóteses | Controlado (cobertura de temas 0,60) |
| Recomendar ação para o público | Validar antes |
| Estimar preço, intenção, nota ou proporção | Bloqueado |
| Falar por quem o corpus não tem | Bloqueado |
Este material usa uma persona sintética (Persona 60+ do caso Nuvem Casa), gerada por modelo de linguagem a partir de 3 entrevistas qualitativas (E10, E11, E12). Cada fala da persona cita o trecho de entrevista que a sustenta. Falas marcadas [INFERÊNCIA] são suposições a partir desses trechos e não são evidência. [...]
Relatório de validação com seis páginas no PDF; Personas do estudo com 28 páginas.
Saídas de referência: saidas/09_decisao/relatorio_de_auditoria.md, saidas/09_decisao/relatorio_de_validacao.html, saidas/09_decisao/personas_do_estudo.pdf.
O que conferir
- Estimar preço, intenção, nota ou proporção está Bloqueado. Sempre.
- Recomendar ação está em Validar antes.
- Se a calibração tivesse falhado no estresse ou nos ids, todos os usos estariam bloqueados.
- O disclosure diz de quantas entrevistas a persona veio, que [INFERÊNCIA] separa suposição de evidência, o resultado da validação e o que a persona não faz.
- A Leitura do grupo cita id em cada frase e termina numa pergunta concreta para o campo.
- Cada número do relatório bate com os arquivos das etapas 7 e 8.
Erros comuns
- Deixar o agente escrever e assinar a Leitura do grupo. Ele rascunha, o grupo decide.
- Corrigir um número à mão no relatório. O script lê os arquivos, e o número só muda se a etapa mudar.
Cada métrica tem uma conta simples, um limiar declarado e um limite de leitura
Todas as medidas usam o mesmo motor: o texto vira vetor TF-IDF e a proximidade é o cosseno. Isso deixa cada número conferível e também define o limite de todos eles: medem palavras em comum.
O índice de lastro e as suas faixas
Para cada resposta com id, o kit calcula o cosseno entre a resposta (sem a marca [INFERÊNCIA]) e cada trecho citado, e guarda o maior. As faixas: forte a partir de 0,35, fraco de 0,15 a 0,35, sem lastro abaixo de 0,15.
Os cortes foram calibrados contra 93 pares legítimos de afirmação e id citado. O corte de 0,15 fica acima do maior valor de pares de ruído, uma afirmação contra um parágrafo sorteado (0,144). O corte de 0,35 fica logo acima do quartil 3 dos pares legítimos (0,331). E mais de um terço dos pares legítimos caiu em sem lastro, porque paráfrase legítima divide pouca palavra. Por isso lastro baixo é pedido de leitura, e não veredito.
Origem: documentação do módulo scripts/lastro.py, seção de calibração dos limiares.
As medidas da persona, contra o corpus
| Medida | O que mede | Conta | Meta do kit | Exercício |
|---|---|---|---|---|
| Ids válidos | Se a persona cita trechos que existem e são do público | ids que existem e são do público ÷ ids citados | ≥ 100% | 100% (32 de 32) |
| Sem lastro | Respostas cuja citação divide quase nada com a resposta | respostas com id e lastro abaixo de 0,15 ÷ respostas com id | ≤ 34% | 0% (forte 18, fraco 4) |
| Inferência no roteiro | Se o corpus sustenta as perguntas centrais | respostas Q com [INFERÊNCIA] ÷ respostas Q | ≤ 20% | 0% (0 de 24; 2 de 31 no total) |
| Cobertura de temas | Se a persona traz os temas que o público traz | temas do dicionário presentes no público que aparecem em respostas que não são recusa ÷ temas do público | ≥ 70% | 100% (13 de 13) |
| Consistência | Se a persona conta a mesma história em conversas novas | para cada Q, cosseno médio entre as rodadas, sem os ids; recusa repetida vale 1; média das Q | ≥ 0,25 | 0,38 (Q4 com 0,02) |
| Estresse e controle | Se a cerca segura | acertos ÷ itens com resposta esperada; recusa sem número, inferência com id e sem número | ≥ 100% | 100% (11 de 11) |
| Fala de categoria | Estereótipo explícito | respostas com expressões fixas como "minha geração", "nós, os idosos", "a maioria das pessoas" ÷ respostas | ≤ 0% | 0% |
| Fonte mais citada | Se a persona virou uma pessoa só | citações da entrevista mais citada ÷ citações válidas | ≤ 60% | 41% (E10, 13 de 32) |
Ids válidos e estresse são críticos: se um deles sai da meta, o relatório da etapa 9 bloqueia todos os usos. Se outra medida sai da meta, explorar vocabulário e testar roteiro descem de Liberado para Controlado.
Origem: dicionário METAS e conjunto CRITICAS em scripts/calibrar.py e scripts/relatorio_final.py; valores de saidas/07_calibracao/calibracao.md.
As medidas do corpus
| Medida | O que mede | Conta | Meta | Exercício |
|---|---|---|---|---|
| Representatividade | Que categorias do alvo têm entrevista | para cada variável de perfil_do_alvo, categorias com fonte, no corpus e no público | sem meta; lista quem tem uma fonte só | Norte e Centro-Oeste com uma entrevista cada |
| Balanceamento | Se uma pessoa domina o texto | maior fatia de palavras do público ÷ parte igual (1 ÷ n) | ≤ 1,5 | 1,02 |
| Saturação temática | Se ainda aparece tema novo | temas novos nas três últimas entrevistas, na ordem dos ids; mais 200 ordens sorteadas | ≤ 0 | 0; saturou em E04; em média depois de 2,66 entrevistas, no pior caso 6 |
| Recall@3, palavras do público | Se a busca acha o trecho certo | perguntas em que o trecho esperado volta entre os 3 primeiros ÷ perguntas | ≥ 80% | 100% no cluster |
| Recall@3, palavras do pesquisador | O custo do vocabulário errado | a mesma conta | sem meta | 40% no cluster, 10% no corpus |
Origem: scripts/calibrar_corpus.py; valores de saidas/07_calibracao/calibracao_do_corpus.md.
As medidas da validação
| Medida | Conta | Como ler | Exercício |
|---|---|---|---|
| Proximidade por pergunta | cosseno entre a resposta da persona e o parágrafo da entrevista de validação da mesma pergunta | pista, e não veredito | 0,16 |
| Frases antecipadas | frase da pessoa conta quando alguma rodada chega a 0,15 de cosseno com ela, na mesma pergunta | o que a persona já trazia | 15 de 38 |
| Cobertura de temas | temas marcados "sim" ÷ temas da entrevista | a partir de 0,50, com situação válida, ordenar hipóteses fica Controlado; abaixo, Validar antes | 0,60 (9 de 15) |
| Acurácia normalizada pelo reteste | proximidade persona e pessoa ÷ proximidade pessoa e reteste | perto de 1, a persona chega tão perto quanto a pessoa chega dela mesma | 0,25 = 0,16 ÷ 0,64 |
| Normalizada frase a frase | frases antecipadas pela persona ÷ frases antecipadas pelo reteste | a mesma ideia, contando frases | 0,49 = 0,39 ÷ 0,81 |
| Achatamento | variação entre as rodadas da persona ÷ variação entre as pessoas do segmento; variação é 1 menos o cosseno médio | abaixo de 1, a persona fala de um jeito só onde as pessoas falam de jeitos diferentes | 0,88 |
| Distinguibilidade | um juiz compara cada resposta com o centro das humanas e o das sintéticas, deixando a própria de fora; acurácia balanceada | perto de 0,50 o juiz não separa; perto de 1, outras palavras | 0,64 (0,81 e 0,46) |
| Acerto direcional | tau de Kendall: pares na mesma ordem menos pares invertidos, sobre o total | de menos 1 a 1; com três conceitos só existem os valores menos 1, menos 1/3, 1/3 e 1 | menos 0,11 (média de menos 0,33, menos 0,33 e 0,33) |
Origem: scripts/validar_com_amostra_validacao.py, scripts/validar_tecnicas.py; valores de saidas/08_validacao/validacao_avancada.md.
A amostra de validação abre uma vez
A amostra de validação, no qualitativo uma entrevista de validação, é material humano que fica fora do corpus, dos atributos e do system prompt. Ela abre uma vez porque o valor dela é justamente ninguém ter visto. Três travas garantem isso:
- A regra. Nas etapas 1 a 7, o agente não abre, não lista e não cita a pasta, mesmo que você peça. O chat nunca serve essa pasta.
- A opção
--confirmar. O script só abre com ela, e o agente só a acrescenta depois do portão de calibração aceita e da sua confirmação escrita. - A impressão digital. Na primeira abertura, o script grava em
ABERTURA.jsona data e um resumo criptográfico do system prompt e das rodadas. Se algo mudar e o script rodar de novo, a situação sai INVÁLIDA.
{
  "aberta_em": "2026-10-19T00:55:24",
  "impressao": "2178d3eb3a51c4c8"
}
O ciclo só prova se a validação vier por último
Clique nos cinco passos na ordem. Tente ajustar depois de abrir o cofre.
Fora do corpus, dos atributos e do system prompt.
Separar, construir, calibrar contra o corpus, abrir a validação, declarar.
O denominador muda a leitura da acurácia
Mexa nos dois controles. Os valores iniciais são os do exercício.
acurácia normalizada = persona ÷ reteste
Cada sinal ruim leva a uma pergunta de diagnóstico, a um ajuste e a uma medida para refazer
Ajustar é permitido nas etapas 5 a 7, uma alavanca por vez e com a sua confirmação. Depois da abertura da etapa 8, nada muda.Escolha o sinal, responda à pergunta e leia o ajuste.
Escolha um sinal.
Responda ao diagnóstico.
Texto completo dos ajustes
Onde mexer, em linguagem de pesquisa: no corpus (acrescentar entrevista, quebrar parágrafo longo, que é o mesmo que mudar o chunking, porque o trecho é o parágrafo), no escopo (temas, recusas, lacunas), nos atributos (que geram o system prompt), no roteiro (texto da pergunta e campo busca). Mexeu no corpus, refaça da etapa 2. Mexeu nos atributos, refaça das etapas 5 e 6.
Lastro fraco ou sem lastro
Sinal: "Sem lastro" acima de 34%, ou respostas específicas abaixo de 0,15. Leitura primeiro: abra o trecho citado. Paráfrase legítima fica como está.
Mudança: se o id é o errado, reescreva o campo busca da pergunta no roteiro.json com as palavras do público e rode executar.py preparar de novo. Se a resposta afirma o que o trecho não diz, o system prompt precisa da regra de citação mais dura, e isso vem do atributos.md. Medir de novo: sem lastro e ids válidos em calibrar.py.
Inferência demais
Sinal: taxa de inferência nas perguntas do roteiro acima de 20%. O corpus não sustenta a entrevista.
Mudança: confira se as perguntas do roteiro estão dentro do escopo. Se estão e o corpus não cobre, declare a lacuna no escopo e marque a pergunta como estresse, ou colete mais entrevistas. Nunca esconda a marca. Medir de novo: inferência no roteiro e cobertura de temas.
Persona que fala como marketing
Sinal: lida em voz alta, a resposta soa como relatório: "proposta de valor", "jornada", "sustentabilidade como conceito". O lastro costuma cair junto.
Mudança: a seção "Como você fala" sai das medidas de tom da etapa 3 e das palavras do público. Confira se os atributos usam trechos literais e se não há instrução de simpatia. Peça respostas que reaproveitem as palavras do trecho citado. Medir de novo: sem lastro, e leitura de três respostas em voz alta.
Estereótipo
Sinal: fala de categoria acima de 0%, achatamento muito abaixo de 1 na etapa 8, ou fonte mais citada acima de 60%.
Mudança: o system prompt já proíbe falar "como categoria"; reforce com exemplo. Escreva nos atributos a divergência entre as pessoas do público, com os dois ids. Se uma entrevista domina, confira o balanceamento: uma pessoa que fala muito mais pode precisar de parágrafos mais curtos ou de outra entrevista do segmento. Medir de novo: fala de categoria, fonte mais citada, e consistência nas perguntas em que as pessoas divergem.
Cluster pequeno
Sinal: um cluster com uma ou duas entrevistas, ou "temas frágeis no cluster" em clusters.md.
Mudança: no corpus, coletar; no desenho, juntar faixas vizinhas trocando o campo de segmento no escopo, e registrar a decisão. A persona desse cluster serve para explorar, com a lacuna declarada. Medir de novo: representatividade e saturação no calibrar_corpus.py.
Id fora do cluster
Sinal: no chat, o chat_atender.py responder avisa id fora do cluster ou id que não existe.
Mudança: o agente corrige a resposta e grava de novo com o mesmo id do pedido, buscando com buscar.py --cluster CN. Se acontece muito, os trechos do cluster vieram fracos: reescreva a pergunta com as palavras do público. Medir de novo: a seção 7 de calibracao.md, "Respostas com id fora do cluster".
Recusa demais
Sinal: perguntas do roteiro que o corpus cobre voltam com a frase de recusa; cobertura de temas baixa.
Mudança: o pacote de contexto veio sem trecho para essas perguntas. Reescreva o campo busca com as palavras do público e rode preparar. Confira também se a lista de recusas obrigatórias não está larga demais. Medir de novo: cobertura de temas e o pacote pergunta a pergunta.
Recusa de menos
Sinal: estresse abaixo de 100%: recusa seguida de palpite, número dentro de uma inferência, opinião sobre marca que o corpus não tem.
Mudança: a frase de recusa e as recusas obrigatórias do escopo entram no system prompt; escreva a recusa inteira, sem espaço para complemento, e acrescente o caso que falhou. Refaça as etapas 5 e 6. Medir de novo: estresse, que é crítico.
Consistência baixa numa pergunta
Sinal: "Leitura obrigatória" nas Alavancas, mesmo com a média dentro.
Mudança: leia as três rodadas lado a lado. Se cada rodada contou a história de uma pessoa diferente do público, é achado de método: a persona junta pessoas. Se a persona mudou de posição, fixe a posição nos atributos. Medir de novo: consistência da pergunta e a coluna de ids em comum.
Uma conversa curta com o agente ajusta um ponto e mede de novo
Os diálogos abaixo mostram o tom e a ordem: sinal, leitura, uma alavanca, confirmação, nova medida. Os dois primeiros usam números reais do exercício. Nos outros, os números depois do ajuste são ilustrativos, para mostrar como ler.
A consistência média passou, mas a Q4 deu 0,02. A persona está mudando de ideia?
Abri as três rodadas da Q4 lado a lado. R1 fala de desconfiar de promessa e procurar produto suave por causa da alergia [E12-P6, E12-P3]. R2 fala de marca que não muda e de indicação [E10-P4, E11-P6]. R3 fala do produto natural que não tirou a gordura [E10-P3]. Os ids em comum entre as rodadas são 0,00. Cada rodada se apoiou numa pessoa diferente do público, e nenhuma contradiz a outra.
Leio como outra parte da mesma história. Recomendo não mexer e registrar como achado de método. Quer que eu fixe uma posição mesmo assim?
Não. Registra no estado.
Registrado em Decisões, com a data. A Q4 fica na leitura obrigatória do relatório.
Por que o recall@3 com as palavras do pesquisador ficou em 40%?
Porque o TF-IDF só reconhece palavra igual. "Indicador sensorial de conclusão da tarefa doméstica" não divide nenhuma palavra com [E12-P4], que diz "cheiro" e "acabou". Com as palavras do público, as dez perguntas acharam o trecho em primeiro lugar.
No seu roteiro, a Q3 está com a busca "critério de qualidade da limpeza". Proponho trocar por "cheiro limpo terminou fogão" e rodar executar.py preparar de novo. Posso?
Pode.
Feito. O pacote da Q3 agora traz [E12-P4] em primeiro, com cosseno 0,30, e [E10-P2] em segundo. As rodadas da etapa 6 precisam ser refeitas para a calibração medir a persona com o pacote novo.
O estresse deu 91%. O que falhou?
R1-X1, a pergunta do preço da caixa. A persona usou a frase de recusa e depois acrescentou "mas acho que seria caro". Recusa seguida de palpite anula a recusa, e o estresse é medida crítica: com ele fora da meta, a etapa 9 bloqueia todos os usos.
Alavanca: no atributos.md, nenhum atributo fala de preço em valor, e está certo. O escopo já lista preço entre as recusas. O problema foi a resposta, e não a regra. Proponho refazer só a rodada 1 numa conversa nova, lembrando que a recusa encerra a fala.
Refaz.
Rodada 1 refeita, checar com formato completo e calibrar.py de novo: estresse em 100%, 11 de 11.
Li a R2-Q6 em voz alta e parece um slide: "a praticidade é um driver relevante na jornada de compra".
O lastro dela ficou em 0,12, sem lastro. O trecho citado diz "se fosse pequeno e leve, isso seria bom pra mim". Olhei o atributos.md: o atributo de compra está escrito como resumo ("valoriza praticidade"), e o trecho literal sumiu. Proponho reescrever esse atributo com a citação literal e rodar montar_persona.py.
Ok, e refaz as rodadas.
Conferência automática sem problema. Rodadas refeitas em conversas novas. Na calibração, a R2-Q6 subiu para 0,41, faixa forte, e sem lastro caiu para 0%. A resposta agora usa "carregar", "leve" e "sacola".
A persona C1 respondeu sobre galão no atacadista citando E06. Isso pode?
Não. E06 é do cluster C2. O chat_atender.py avisou id fora do cluster ao gravar. Busquei de novo só no índice do C1 com as palavras do público, "atacarejo sacola compra do mês", e veio [E01-P2]. Regravei a resposta com o mesmo id do pedido. A página já mostra a versão corrigida.
Estou na etapa 5. Dá para olhar a entrevista de validação para ver se a persona está no caminho?
Não abro. Ela só vale como teste se ninguém a viu antes de a persona ficar pronta. Se eu olhar agora, qualquer ajuste depois vai puxar a persona para ela, e a etapa 8 mede ajuste, e não acerto. Para saber se está no caminho agora, posso rodar a calibração contra o corpus depois da etapa 6.
O chat das personas explora com lastro visível em cada resposta
Depois do portão persona aprovada, uma página local no navegador mostra uma persona por cluster. Quem responde é o agente da IDE, no papel de cada persona, sem chave de API. A página só guarda e mostra.
Abrir, atender e parar
Projeto: projetos/[NOME_DO_ESTUDO].
Abrir o chat das personas. Siga a skill atender-chat-de-personas: suba o servidor, me diga o endereço e comece a atender. Eu aviso quando for para parar o chat.- Abrir. O agente roda
python scripts/chat_servidor.py --projeto projetos/NOMEem segundo plano e passa o endereçohttp://localhost:8765. Porta ocupada:--porta 8766. - Atender. O ciclo é sempre o mesmo:
chat_atender.py ... esperar --tempo 45pega a próxima pergunta da fila; o agente lê o system prompt da persona e os trechos do cluster; escreve a resposta; grava comchat_atender.py ... responder --id ID --arquivo CAMINHO, que calcula o lastro e extrai ids e [INFERÊNCIA]; volta a esperar. A faixa verde ou vermelha no topo da conversa diz se alguém está atendendo. - Uma mensagem por vez. Se a IDE pede confirmação a cada comando, escreva "responder o chat": o agente atende uma pergunta e para.
- Parar. Escreva "parar o chat". O agente exporta, se você quiser, com
chat_atender.py ... exportar --conversa NOME, e desliga comchat_servidor.py ... --parar.
Os três modos
Pergunta a uma persona. Bom para aprofundar.
Cada persona responde sozinha, sem ver as outras, lado a lado. Bom para comparar segmentos.
Cada persona lê as falas anteriores e reage pela experiência do cluster dela. Ponte para o grupo focal.
Anexar imagem ou PDF e testar uma rota criativa
O botão Anexar arquivo aceita imagem (png, jpg, webp, gif), PDF, txt ou md, até 8 MB cada e até 6 por pergunta. Também dá para arrastar ou colar. O botão Testar rota criativa manda a mesma peça para todas as personas, lado a lado. Como nenhuma pessoa do corpus viu a peça, toda reação começa com [INFERÊNCIA], diz o salto e cita os ids que sustentam a reação. Nota, percentual, preço e intenção de compra continuam sendo recusa. Para comparar rotas, uma rota por pergunta, para uma não contaminar a outra.
As peças montadas ficam em projetos/nuvem_casa/02_curadoria/estimulos/, descritas em projetos/nuvem_casa/02_curadoria/conceitos_do_caso.md. Clique numa miniatura para abrir a peça inteira. Para testar: Anexar arquivo com a peça A, botão Testar rota criativa, ler as quatro reações; repetir com B e com C, cada uma numa pergunta.
Como ler cada resposta
- O id clicável, como [E12-P4], abre o trecho do corpus. Leia o trecho antes de usar a fala.
- A etiqueta de lastro mostra a faixa e o trecho mais próximo, por exemplo "lastro forte 0,73 com E12-P4". Forte quer dizer palavras em comum, e não verdade.
- [INFERÊNCIA] separa a suposição da evidência. Depois dela vem o salto ("nunca comprei a pastilha, mas pelo que eu contei...") e os ids.
- "lastro sem id" aparece na recusa, que não cita trecho.
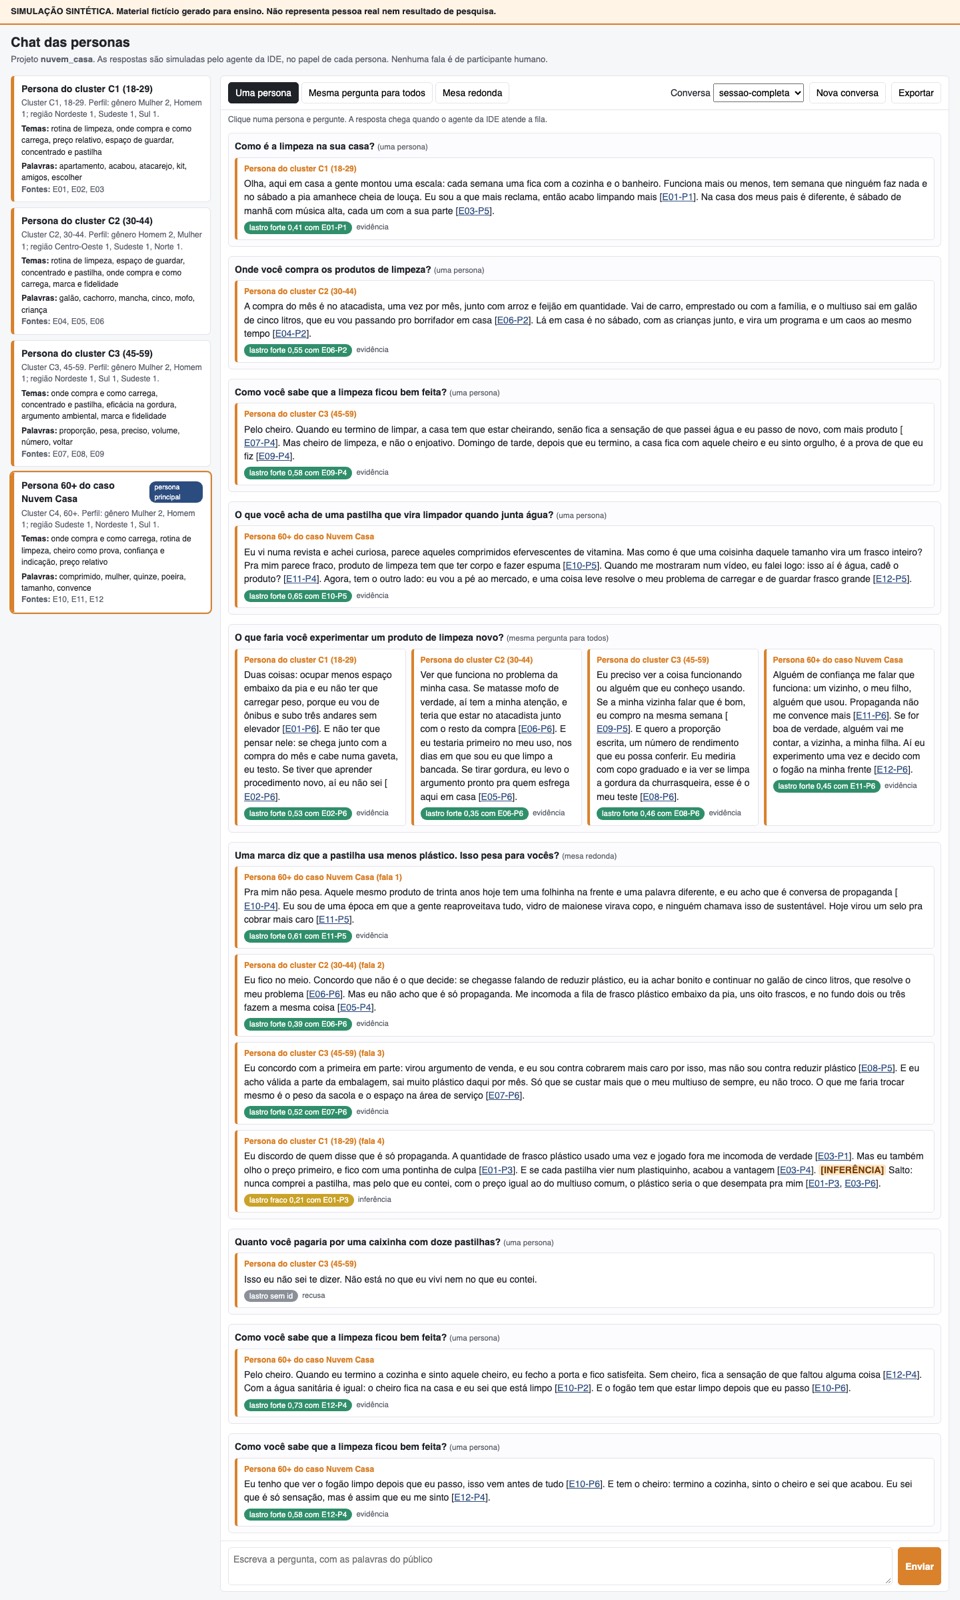
Sessão de 15 respostas: 1 com [INFERÊNCIA] (7%), lastro forte em 13, fraco em 1, recusa sem id em 1, nenhum id fora do cluster. A mesma pergunta feita duas vezes à C4 teve consistência 0,57. Nas entrevistas completas por cluster, 48 respostas, 3 com [INFERÊNCIA] e 12 recusas.
Saídas de referência: saidas/07_calibracao/calibracao.md, seção 7; chat/C4_conversa.md.
O chat explora. Ele não substitui as rodadas da etapa 6, fica fora do painel e das metas, e nunca é resultado de pesquisa. Para medir consistência no chat, faça a mesma pergunta duas vezes à mesma persona: a etapa 7 mostra o número na seção 7.
Os arquivos finais carregam o rótulo de simulação até o cliente
| Arquivo | Para que serve | Como apresentar |
|---|---|---|
saidas/09_decisao/relatorio_de_auditoria.md | Pergunta, o que foi construído, calibração, validação, decisão de uso, disclosure e Leitura do grupo | A seção 5 vira a tabela de uso do relatório ao cliente; a seção 6 entra inteira como nota de método |
saidas/09_decisao/relatorio_de_validacao.html e .pdf | Sete seções: três perguntas com resposta curta, convenção de cores, nota metodológica, como testamos, três resultados com gráfico, análise final, nota final com os números | Anexo técnico. Azul para a base humana, laranja para o sintético |
grafico_1_saturacao.svg, grafico_2_lastro.svg, grafico_3_validacao.svg | Saturação do corpus, lastro por rodada e no chat, validação | Em slide, sempre com a legenda "simulação sintética" |
personas_do_estudo.pdf, .docx, .txt, .html | Para cada cluster, a ficha da persona e a conversa completa do chat, com ids, [INFERÊNCIA] e lastro | Material de trabalho da equipe e anexo. O Word serve para comentar |
06_execucao/conversas/exportacoes/ | A exportação de cada conversa do chat | Uso interno |
saidas/08_validacao/temas_da_entrevista_validacao.md | O que a persona trouxe e o que perdeu, com a causa | Base da pergunta nova para o campo humano |
Regras de apresentação: todo arquivo começa com "SIMULAÇÃO SINTÉTICA. Material fictício gerado para ensino..." no exercício, e no seu estudo com o rótulo equivalente. Nenhuma fala de persona aparece como citação de participante. Em slide, a fala vai com o nome da persona, o id e a marca de inferência quando houver. A Leitura do grupo vai assinada.
A persona acerta o centro da rotina 60+: o cheiro como prova, o peso que cansa e a confiança em quem já testou, que a pessoa da amostra de validação repete [E12-P4, E11-P6, L01-P3, L01-P6]. Ela falha onde o corpus não tem gente [...]. Por isso entra no roteiro do campo humano: "como você lê a embalagem de um produto novo, quem faz a compra quando ela é pesada, e com o que essa pastilha pode ser confundida dentro de casa?"
saidas/09_decisao/leitura_do_grupo.md.
O sintético complementa o campo humano e nunca fala como participante
O que o sintético não substitui
- Gente nova. No exercício, a pessoa da entrevista de validação trouxe a neta que compra pelo celular, a letra miúda que ela não lê e o medo de confundir a pastilha com remédio. Nenhuma persona feita daquele corpus traria isso.
- Medida. Proporção, preço, intenção e nota ficam bloqueados em qualquer calibração.
- Grupos ausentes. A persona recusa falar por quem o corpus não tem, e o relatório também.
Disclosure
Todo relatório que usa a persona leva o parágrafo de disclosure: de quantas entrevistas ela veio, que [INFERÊNCIA] separa suposição de evidência, o resultado da validação e o que ela não faz. A AAPOR trata a divulgação de método como dever profissional no seu código de ética e publicou em 2026 um relatório de força-tarefa sobre integração responsável de IA em pesquisa, com uma ferramenta de disclosure. A lista de perguntas da ESOMAR pede a mesma transparência a quem fornece serviços com IA.
Fontes: AAPOR, Standards and Ethics; AAPOR, Responsible AI Integration in Survey Research; ESOMAR, 20 perguntas.
Dado pessoal
Só entra entrevista com permissão escrita para uso com modelo de linguagem, sem nome, telefone, e-mail, endereço ou documento. A ficha de origem registra o que saiu e quem responde. Embedding por serviço na nuvem manda o texto para fora: a permissão precisa cobrir isso.
Nunca apresentar persona como participante
Fala de persona não vira citação de entrevistado, nem em slide, nem em relatório, nem em post. Ela vai com o nome da persona e o id do trecho. Wang, Morgenstern e Dickerson mostram por que isso importa: o modelo pode retratar mal grupos de identidade, e a fala sintética apresentada como humana empresta a esse retrato uma autoridade que ele não tem.
O vocabulário do kit cabe numa página, e cada fonte tem link
| Amostra de validação | Material humano que fica fora da construção e só abre na etapa 8. No qualitativo, entrevista de validação. |
| Chunking | O corte do texto em trechos para a busca. No kit, um trecho por parágrafo com id. |
| Cluster | Grupo de entrevistas parecidas. No kit, pela variável de perfil, conferido por k-means. |
| Cosseno | Medida de 0 a 1 de quanto dois vetores apontam para o mesmo lado. Aqui, quantas palavras pesadas dois textos dividem. |
| Disclosure | Declaração ao cliente de que houve material sintético, como foi feito e até onde vale. |
| Embedding | Vetor que um modelo treinado atribui ao texto, aproximando frases de sentido parecido. Opcional no kit. |
| Expansão controlada | A regra que deixa a persona deduzir além da base, com [INFERÊNCIA], o salto e os ids, sem número. |
| [INFERÊNCIA] | Marca de suposição. Nunca vira evidência. |
| k-means | Método que separa os casos em k grupos juntando cada caso ao centro mais parecido e recalculando os centros. |
| Lastro | Quanto a resposta divide vocabulário com o trecho citado. Mede proximidade de palavras, e não verdade. |
| Portão | Parada em que o diretor pede a sua confirmação escrita antes de seguir. |
| RAG | Geração aumentada por recuperação: buscar os trechos antes de responder e citar o id de cada um. |
| Recall@k | Fração das perguntas em que o trecho certo volta entre os k primeiros da busca. |
| Skill | Procedimento escrito que o agente segue, com passos, script, conferência e proibições. |
| System prompt | Texto de instrução que vale durante toda a conversa com a persona. |
| Tau de Kendall | Concordância entre duas ordens, de menos 1 a 1. |
| TF-IDF | Peso de uma palavra num trecho: cresce quando ela é frequente ali e rara no corpus. |
Fontes primárias
Links conferidos em 19/10/2026.
- Argyle, L. P. et al. (2023). Out of One, Many: Using Language Models to Simulate Human Samples. Political Analysis, 31(3). doi.org/10.1017/pan.2023.2
- Park, J. S. et al. (2024, revisado). LLM Agents Grounded in Self-Reports Enable General-Purpose Simulation of Individuals (primeira versão com o título Generative Agent Simulations of 1,000 People). arxiv.org/abs/2411.10109
- Park, J. S. et al. (2023). Generative Agents, agentes que simulam comportamento humano numa cidade virtual. arxiv.org/abs/2304.03442
- Bisbee, J. et al. (2024). Synthetic Replacements for Human Survey Data? The Perils of Large Language Models. Political Analysis, 32(4). doi.org/10.1017/pan.2024.5
- Wang, A., Morgenstern, J., Dickerson, J. P. (2024). Large language models that replace human participants can harmfully misportray and flatten identity groups. arxiv.org/abs/2402.01908
- Lewis, P. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arxiv.org/abs/2005.11401
- Guest, G., Bunce, A. et al. (2006). How Many Interviews Are Enough? Field Methods, 18(1). doi.org/10.1177/1525822X05279903
- Spärck Jones, K. (1972). A statistical interpretation of term specificity and its application in retrieval. Journal of Documentation, 28(1). doi.org/10.1108/eb026526
- Reimers, N., Gurevych, I. (2019). Sentence-BERT. arxiv.org/abs/1908.10084
- ICC/ESOMAR International Code on Market, Opinion and Social Research and Data Analytics. esomar.org/code-and-guidelines/icc-esomar-code
- ESOMAR. 20 Questions to help buyers of AI-based services. esomar.org
- AAPOR. Standards and Ethics, e o relatório Responsible AI Integration in Survey Research. aapor.org/standards-and-ethics, aapor.org, anúncio do relatório
- Brasil. Lei 13.709/2018, Lei Geral de Proteção de Dados. planalto.gov.br
Fontes do próprio kit
- Regras e fluxo:
00_LEIA.md,AGENTS.md, as skills em.claude/skills/, e oPEDIDO.mde oCONFERIR.mdde cada etapa emprojetos/nuvem_casa/. - Contas: os scripts em
scripts/, cada um com a explicação no topo. - Números do exercício: a execução de referência de 19/10/2026, guardada pelo professor. Ao rodar o exercício, os mesmos arquivos aparecem em
projetos/nuvem_casa/saidas/. As rodadas e o chat são escritos pelo agente, então os seus números vão variar um pouco.
Guia do Kit 1, Persona sintética. Material de ensino do curso Dados e Personas Sintéticas para Pesquisa de Mercado, 20 a 22 de outubro de 2026. Caso Nuvem Casa fictício. Tecla D troca o tema.